
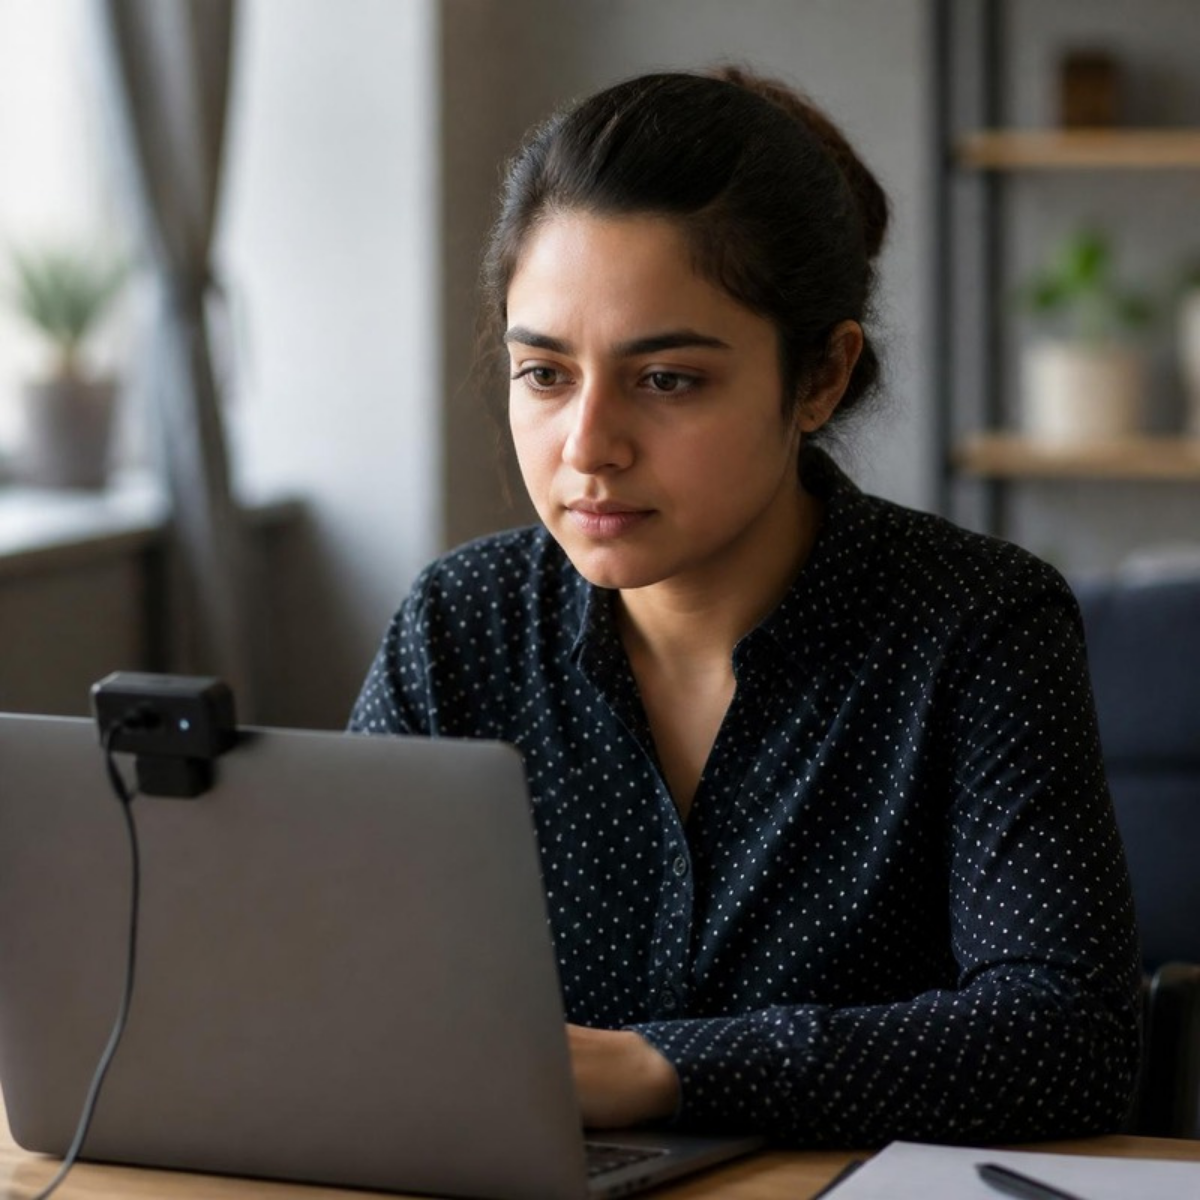
Ein Blick zur Seite. Ein Geräusch im Hintergrund. Ein Videobild, das für zwei Sekunden einfriert. In einer Remote-Prüfung kann all das Betrug sein. Oder einfach nur ein schlechtes WLAN.
Die A4Q Global Services GmbH aus Oberhaching hat erforscht, ob eine KI den Unterschied zuverlässig erkennt. Und ob sie offene Prüfungsantworten so bewerten kann, dass zweimal dieselbe Antwort auch zweimal dieselbe Note bekommt.
Zwischen Betrug und Fehlalarm
Remote-Prüfungen haben zwei offene Flanken. Die Täuschungserkennung versagt, sobald die Umgebung unruhig wird: schwankende Bandbreiten, wechselnde Kameraperspektiven, Licht und Schatten. Harmlose Ereignisse sehen dann aus wie Täuschung, echte Täuschung geht im Rauschen unter.
Die zweite Flanke sind Freitexte. Sprachmodelle können offene Antworten bewerten, aber nicht deterministisch. Sie halluzinieren, sie urteilen je nach Kontext anders. Für eine Zertifizierungsprüfung ist das inakzeptabel. Bestehende Systeme lösen jeweils nur einen Teil des Problems: Überwachung oder Bewertung, selten beides, kaum unter realen Störbedingungen.

A4Q: Zertifizierungen für die IT-Welt
A4Q steht für Alliance for Qualification. Unter dieser Marke entstehen Qualifizierungsinhalte und Zertifizierungsschemata für IT-Fachleute. Die A4Q Global Services GmbH mit Sitz in Oberhaching bei München verantwortet das Forschungsvorhaben.
Das Kernteam im Unternehmen ist klein. Die Forschung selbst lief deshalb von Anfang an vollständig als Auftragsforschung: fünf externe Partner in Deutschland und Tschechien, koordiniert über eine gemeinsame wissenschaftlich-technische Ausrichtung. Begonnen hat das Vorhaben im Januar 2022, es läuft bis Ende 2026.
Fünf Datenströme, ein Urteil
Der Kern ist multimodale Sensorfusion. Audio, Video und Interaktionsdaten laufen asynchron und in schwankender Qualität ein. Das Team entwickelte Verfahren, diese Ströme zeitlich zu synchronisieren und zu einem robusten Gesamtbild zu verschmelzen, auf dem neuronale Modelle Anomalien erkennen.
Parallel wurden Sprachmodelle domänenspezifisch angepasst. Kuratierte Prüfungstexte, iterative Trainings- und Feedbackzyklen und Ensemble-Ansätze über mehrere Modellarchitekturen sollen Halluzinationen eindämmen und Bewertungen stabil machen. Die Messlatte war klar gesetzt: über 95 Prozent Erkennungsgenauigkeit bei unter 2 Prozent Fehlalarmen.
Wenn ein Ansatz scheitert
Nicht jeder Weg hielt der Realität stand. Die zuerst entwickelte Systemarchitektur erfüllte die Anforderungen an Datenverarbeitung, Modellintegration und Robustheit unter realen Bedingungen nicht. Die Arbeiten wurden neu strukturiert und von anderen Partnern weitergeführt.
Genau das ist Forschung. Ob sich eine generalisierbare Lösung überhaupt realisieren lässt, war von Beginn an ungewiss. Ob die Datenkonsistenz reicht, um echte Täuschungsversuche von harmlosen Ereignissen zu trennen, ebenso. Und ob Trainingsmechanismen eine stabile Bewertungslogik garantieren können, auch.
Forschung ohne eigenes Labor
Auftragsforschung ist voll förderfähig. Viele Unternehmen wissen das nicht. Sie glauben, ohne eigene Entwicklungsabteilung gebe es keine Forschungszulage. Entscheidend ist aber, dass die beauftragten Arbeiten überwiegend Forschungscharakter haben und zum Ziel des Vorhabens beitragen.
Banhoek Consulting grenzte das Vorhaben sauber vom Stand der Technik ab, ordnete die Arbeiten aller fünf Auftragnehmer dem Forschungsziel zu und benannte die Risiken konkret. Der Bescheid kam am 10. Juli 2026, rund zwei Monate nach Antragstellung. Alle drei Kriterien erfüllt, rückwirkend ab Januar 2022.