Ein Avatar, der eine halbe Sekunde zu spät antwortet, ist kein Avatar mehr. Er ist eine Software, die man beim Nachdenken beobachtet. Der Unterschied zwischen Gegenüber und Werkzeug liegt im Millisekundenbereich.
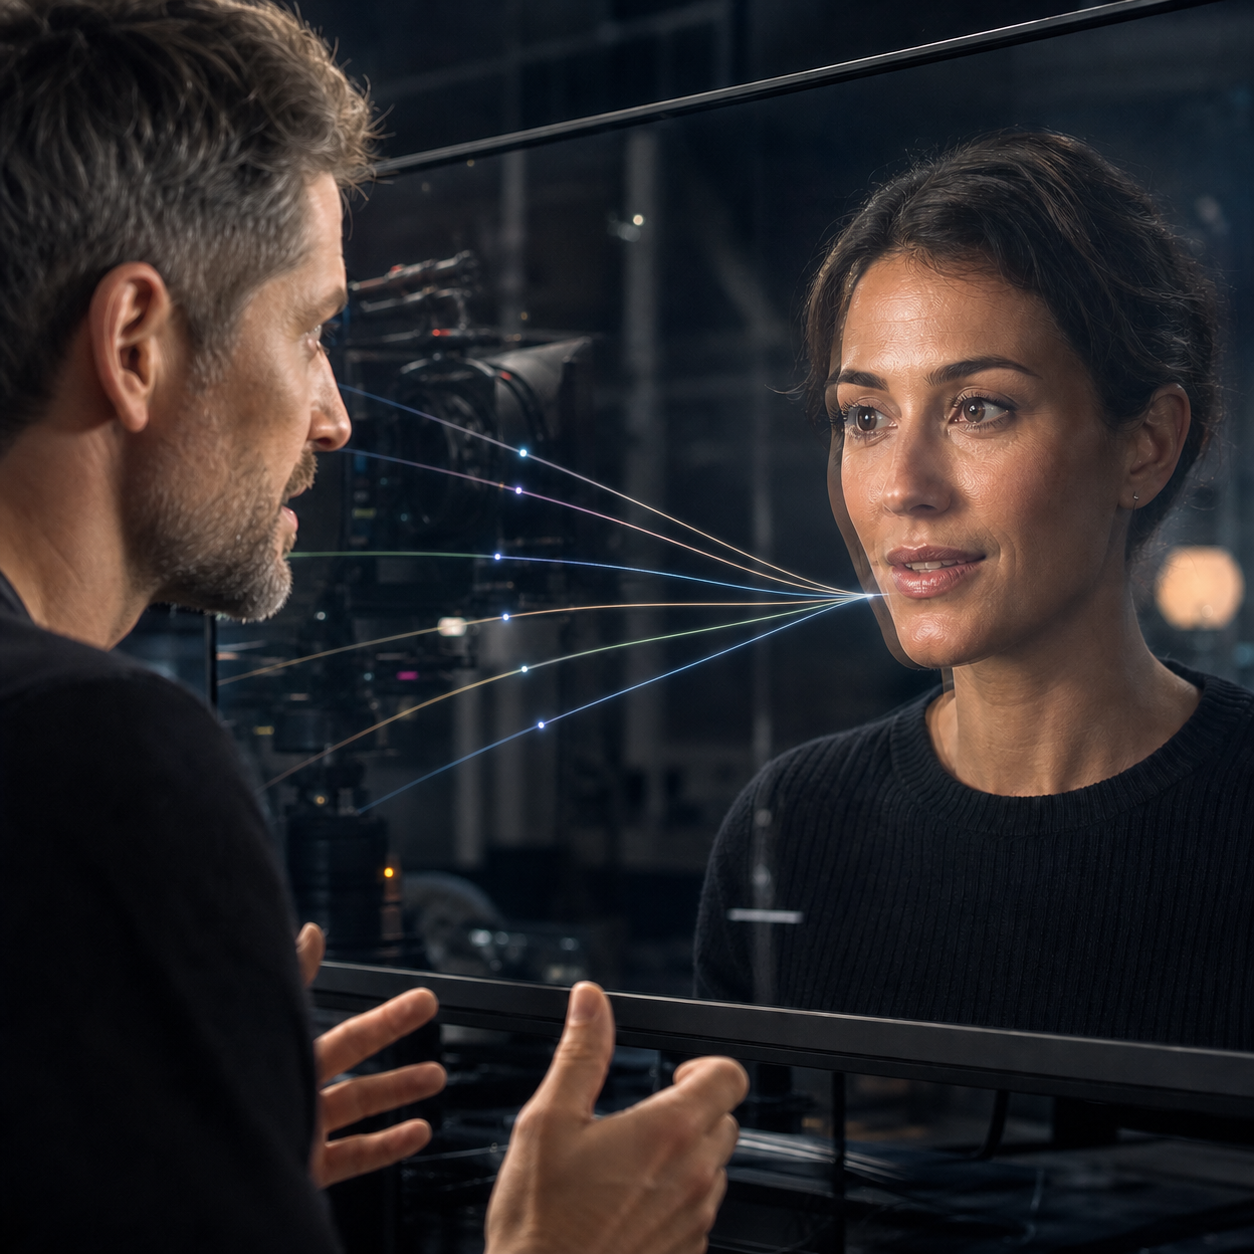
Hinter einem einzigen gesprochenen Satz arbeiten sechs KI-Modelle gleichzeitig. Die VidLab7 GmbH aus München hat erforscht, wie man sie so synchronisiert, dass niemand die Naht sieht.
Gute Einzelteile, kein Ganzes
Die Bausteine gibt es längst. Spracherkennung, Sprachmodelle, Sprachsynthese, Diffusionsmodelle für Bildsynthese, Emotionserkennung — jedes für sich leistungsfähig und verfügbar.
Was fehlte, waren die Verfahren dazwischen. Es existierten keine etablierten Methoden, um diese Module unter Echtzeitbedingungen zuverlässig zu synchronisieren, Übergaben zwischen ihnen adaptiv zu steuern und dabei konsistente Reaktionen in Sprache, Bild und Emotion zu erzeugen. Wer sechs Modelle parallel laufen lässt, bekommt Latenzsprünge, Kontextverluste und ein Gesicht, dessen Mimik nicht zu dem passt, was der Mund sagt.
VidLab7: KI-Avatare aus München
Die VidLab7 GmbH wurde 2024 in München von Fabian Beringer und Georgi Anastasov gegründet. Beringer hatte zuvor bereits das KI-Unternehmen e-bot7 aufgebaut und 2021 verkauft. Die Plattform erzeugt KI-Avatare, die in Marketing und Kundenservice eigenständig agieren — angebunden an Salesforce und HubSpot.
Von Juli 2024 bis Dezember 2025 lief parallel zum Produktaufbau ein Forschungsvorhaben: 98,5 Personenmonate an einer multimodalen Echtzeitarchitektur. Neun Vollzeitkräfte im Unternehmen, ergänzt um externe Entwicklungspartner.
Die Sekunde als Grenze
Das Ziel war klar beziffert: Die gesamte Kette von der erkannten Sprache bis zum gerenderten, sprechenden, mimisch passenden Avatar sollte unter einer Sekunde bleiben. Ob das überhaupt erreichbar ist, war zu Projektbeginn offen — bei parallelen Modellaufrufen, GPU-Encoding und gleichzeitiger Kontextfusion.
Erforscht wurden Verfahren auf mehreren Ebenen: eine latenzarme Pipeline mit Modellkompression und GPU Scheduling, multimodale Kontextfusion, robuste Zero-Shot-Avatarerzeugung und eine adaptive Orchestrierung, die mehrere spezialisierte Module unter wechselndem Kontext koordiniert.
Die offenen Fragen waren anspruchsvoll: Timing Jitter. Artefaktbildung bei Zero-Shot-Generierung. Skalierungsgrenzen beim RAG-Retrieval über große Dokumentenmengen. Und die Frage, ob die Orchestrierung stabil bleibt, wenn ein Gespräch unvermittelt das Thema wechselt.
Warum eine Pipeline Forschung ist
Der schwierigste Punkt im Antrag war die Abgrenzung zum Stand der Technik. Wer STT, LLM und TTS einsetzt, nutzt bekannte Technologien — das allein trägt keine Bescheinigung. Entscheidend war der Nachweis, dass die Neuartigkeit nicht in den Modellen liegt, sondern in den Schnittstellen, Synchronisationsverfahren und Steuerungslogiken zwischen ihnen.
Banhoek Consulting stellte die Anforderung an Echtzeitsynchronisation, die Kopplung heterogener Modellklassen und die eigens zu entwickelnden Prüfverfahren für sprachliche und visuelle Konsistenz in den Mittelpunkt. Die Bescheinigungsstelle folgte dieser Argumentation ausdrücklich und hielt fest, dass sich die Arbeiten hinreichend von routinemäßigen Änderungen an bestehenden Lösungen abgrenzen lassen.
Der Bescheid kam am 5. Februar 2026. Alle drei Kriterien erfüllt — Neuartigkeit, Unwägbarkeit, Planmäßigkeit.

Was Startups übersehen
Junge KI-Unternehmen halten sich selten für Forschungsunternehmen. Sie bauen ein Produkt, lösen dabei Probleme, für die es keine Blaupause gibt, und nennen das Entwicklung. Genau diese Probleme sind aber der Kern dessen, was das Forschungszulagengesetz fördert.
Wer das erst nach der Finanzierungsrunde entdeckt, hat trotzdem nichts verloren. Aufwände aus zurückliegenden Jahren bleiben rückwirkend förderfähig. Und anders als Wagniskapital kostet die Forschungszulage keine Anteile.